
En este tutorial vamos a ver los tres modelos de datos que existen para multi-tenancy, con ejemplos en SQL, y vamos a comparar cuándo conviene cada uno.
Es contenido de nivel avanzado: doy por hecho que ya saben modelar bases de datos relacionales y que manejan conceptos como índices, transacciones y administración de instancias.
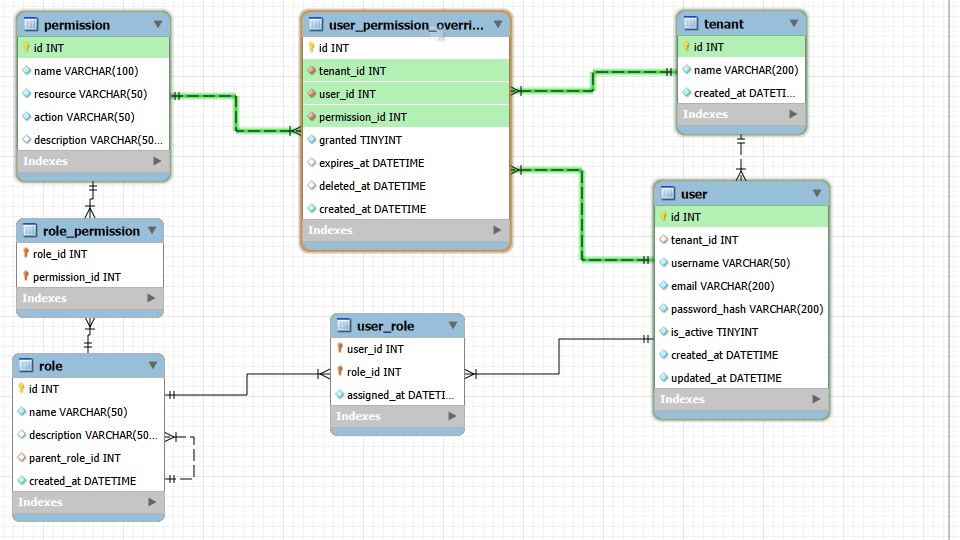
Ya había escrito sobre el modelo de base de datos para un sistema RBAC multi-tenant, donde armamos las tablas de tenant, user, role y permission. Ese modelo daba por sentado un solo tipo de arquitectura de datos: todos los tenants compartiendo las mismas tablas.
¿Qué es multi-tenancy?
Multi-tenancy es el patrón donde una sola instancia de la aplicación le da servicio a varios clientes o tenants — empresas, equipos, usuarios individuales, lo que sea su unidad de cliente — y sus datos quedan lógicamente separados entre sí. Es lo opuesto a single-tenancy, donde cada cliente tiene su propia instalación completa.
La gracia está en la eficiencia: en vez de mantener 500 instalaciones para 500 clientes, mantienen una sola, y todos comparten el mismo código, la misma infraestructura y, según el modelo, la misma base de datos.
El problema es que compartir infraestructura y aislar datos tiran para lados opuestos. Cuanto más comparten, más barato y simple es operar, pero más expuestos quedan a que un bug mezcle datos de un tenant con otro; cuanto más aíslan, más seguro y personalizable resulta, pero también más caro y complejo de operar a escala. Ahí es donde entran los tres modelos.
Los tres modelos de datos multi-tenant
1. Base de datos compartida, esquema compartido (shared schema)
Es el modelo más común, sobre todo en las primeras etapas de un SaaS: todos los tenants viven en las mismas tablas, y cada fila lleva una columna tenant_id que indica a quién pertenece. Es el mismo patrón que usamos en el modelo RBAC: una sola tabla user, un solo tenant_id por fila.
Cómo se implementa
create table tenant (
    id int not null auto_increment primary key,
    name varchar(200) not null,
    created_at datetime not null
);

create table order_item (
    id int not null auto_increment primary key,
    tenant_id int not null,
    customer_name varchar(200) not null,
    total decimal(10,2) not null,
    created_at datetime not null,
    foreign key (tenant_id) references tenant(id)
);

create index idx_order_item_tenant on order_item (tenant_id);
Toda query que toque order_item tiene que filtrar por tenant_id, sin excepción:
select * from order_item
where tenant_id = 42
and created_at >= '2026-01-01';
Ventajas
- Es el más barato de operar: una sola base de datos, un solo set de migraciones, un solo pool de conexiones.
- Escala bien en cantidad de tenants: miles o millones de filas con
tenant_idno son problema para un motor relacional bien indexado. - Los reportes cross-tenant — analítica interna, billing agregado — son triviales porque todo vive en las mismas tablas.
Desventajas
- El aislamiento depende por completo de la disciplina del código de aplicación: si un desarrollador se olvida el
WHERE tenant_id = ?en una query, genera una fuga de datos entre clientes. Y esto pasa, más seguido de lo que gustaría admitir, en SaaS reales. - Aparece el problema del “noisy neighbor”: un tenant con mucho volumen de datos o queries pesadas degrada la performance de todos los demás, porque comparten el mismo motor.
- El cumplimiento normativo se complica: si un cliente enterprise pide “quiero mis datos en un servidor separado” o “necesito que residan en la UE”, con shared schema no es tan simple dárselo.
2. Base de datos compartida, esquema aislado por tenant (schema-per-tenant)
Acá subimos un escalón de aislamiento sin llegar a separar instancias completas de base de datos. Motores como PostgreSQL soportan múltiples schemas dentro de la misma base, y cada tenant tiene el suyo, con las mismas tablas replicadas por esquema.
Cómo se implementa
-- Un schema por tenant, mismas tablas en cada uno
create schema tenant_42;
create table tenant_42.order_item (
    id int not null generated always as identity primary key,
    customer_name varchar(200) not null,
    total decimal(10,2) not null,
    created_at timestamp not null
);

create table tenant_43.order_item (
    id int not null generated always as identity primary key,
    customer_name varchar(200) not null,
    total decimal(10,2) not null,
    created_at timestamp not null
);
La aplicación resuelve a qué schema apuntar según el tenant autenticado, típicamente seteando el search_path de la conexión al arrancar la request:
set search_path to tenant_42;
select * from order_item where created_at >= '2026-01-01';
Ventajas
- Hay aislamiento real a nivel de motor: ya no depende de que el código nunca se olvide un filtro, porque las tablas están físicamente separadas.
- Permite personalizar el esquema por cliente — una columna extra para un tenant puntual, por ejemplo — sin tocar a los demás.
- El backup y restore selectivo por tenant es factible: se puede restaurar un schema puntual sin tocar el resto.
Desventajas
- Las migraciones dejan de correr una vez y pasan a correr una vez por cada schema. Con 50 tenants no es grave; con 5.000, se vuelve una operación larga y riesgosa.
- Los pools de conexión se complican, porque cada request necesita resolver y cambiar de schema, y hay que manejar bien el pooling para no generar cuellos de botella.
- Sigue siendo una sola instancia de base de datos, así que el noisy neighbor a nivel de hardware — CPU, IO — no desaparece del todo.
- Las analíticas cross-tenant requieren consultar N schemas o mantener aparte un proceso de agregación.
3. Base de datos aislada por tenant (silo / database-per-tenant)
El máximo nivel de aislamiento posible: cada tenant tiene su propia base de datos, y a veces hasta su propia instancia o servidor. La aplicación mantiene un “registro de tenants” — una base de datos de control, más chica — que indica a qué connection string apuntar según quién esté logueado.
Cómo se implementa
-- Base de datos de control (una sola, chica, compartida)
create table tenant_registry (
    id int not null auto_increment primary key,
    name varchar(200) not null,
    db_host varchar(200) not null,
    db_name varchar(200) not null,
    db_user varchar(100) not null,
    plan varchar(50) not null,
    created_at datetime not null
);
Cuando llega una request, la aplicación busca al tenant en ese registro, arma la conexión correspondiente y recién ahí ejecuta las queries de negocio contra la base de datos dedicada de ese tenant.
Ventajas
- El aislamiento es máximo: un bug o un pico de carga en un tenant no puede afectar a otro, porque ni siquiera comparten motor de base de datos.
- Es el modelo que mejor responde a requisitos de compliance duros — HIPAA, contratos de residencia de datos, auditorías puntuales.
- Permite ofrecer SLAs de performance diferenciados por cliente, algo típico en tiers “Enterprise”.
Desventajas
- Es el más caro: cada base de datos consume recursos propios aunque el tenant tenga poco tráfico.
- Operar migraciones, monitoreo y backups a escala de cientos o miles de bases independientes es un problema de ingeniería en sí mismo, que necesita automatización seria: orquestación de migraciones, infraestructura como código.
- Las analíticas cross-tenant son las más costosas de armar; por lo general requieren un pipeline de ETL que consolide datos de todas las bases en un data warehouse aparte.
Comparativa rápida
| Criterio | Shared schema | Schema per tenant | DB per tenant |
|---|---|---|---|
| Aislamiento de datos | Bajo (depende del código) | Medio (a nivel de motor) | Alto (físico) |
| Costo de infraestructura | Bajo | Medio | Alto |
| Complejidad de migraciones | Baja (una sola vez) | Media (por schema) | Alta (por base) |
| Riesgo de fuga entre tenants | Mayor | Menor | Mínimo |
| Personalización por tenant | Difícil | Posible | Total |
| Analítica cross-tenant | Fácil | Media | Difícil |
| Apto para compliance estricto | No | Parcial | Sí |
| Cantidad de tenants recomendada | Miles a millones | Decenas a cientos | Decenas (salvo automatización fuerte) |
Modelos híbridos: la estrategia de la mayoría de los SaaS reales
En la práctica, pocos SaaS usan un solo modelo para todos sus clientes; lo más común es armar un esquema por tiers:
- Free / Starter: shared schema, porque ahí está el volumen más alto de tenants y el menor margen por cliente, así que el costo operativo tiene que ser mínimo.
- Business: schema-per-tenant, o un shared schema con particionamiento más fino — varios pools de bases de datos (shards), cada uno sirviendo a un subconjunto de tenants.
- Enterprise: database-per-tenant, a veces en infraestructura dedicada como una VPC propia, que es donde aparecen los requisitos de compliance y los contratos que justifican el costo extra.
Este enfoque se conoce como pooling por tiers, y le permite al SaaS mantener costos bajos en la base de la pirámide mientras ofrece el nivel de aislamiento que los clientes grandes están dispuestos a pagar.
Cómo elegir el modelo según la etapa de tu SaaS
- MVP o validación temprana: shared schema, sin dudarlo — necesitan velocidad de desarrollo y bajo costo operativo, no aislamiento perfecto. Es el modelo que usa, de hecho, la plantilla de tenants con
tenant_iddel artículo anterior sobre RBAC. - Producto con tracción y primeros clientes grandes: empiezan a aparecer pedidos de aislamiento puntual, y ahí es típico migrar selectivamente algunos tenants a schema-per-tenant o a una DB dedicada, sin tocar el modelo del resto.
- SaaS enterprise o en industrias reguladas (salud, finanzas, gobierno): conviene planificar database-per-tenant desde el diseño, porque migrar de shared a silo con clientes ya en producción es una operación delicada — dual-write, backfill, corte de tráfico — que mejor evitar si ya saben que la van a necesitar.
Seguridad: el punto donde más SaaS fallan
Sin importar el modelo que elijan, la fuga de datos entre tenants es el bug más caro que pueden tener, no solo técnicamente sino en confianza de marca. Algunas prácticas ayudan a prevenirla.
Row-Level Security (RLS) en shared schema
Si usan PostgreSQL, no dependan solo de que el código de aplicación agregue el WHERE tenant_id. Usen RLS para que el motor mismo rechace cualquier fila que no pertenezca al tenant de la sesión actual:
alter table order_item enable row level security;

create policy tenant_isolation on order_item
using (tenant_id = current_setting('app.current_tenant')::int);
Con esto, aunque una query se olvide el filtro, el motor no devuelve filas de otro tenant.
Middleware de resolución de tenant
El tenant activo debería resolverse una sola vez, temprano en el ciclo de vida de la request — a partir del subdominio, un header o el JWT de autenticación — y quedar disponible para toda la capa de datos, en vez de repetirse manualmente en cada query.
Tests automatizados de aislamiento
Un test que, con datos de dos tenants distintos, verifique explícitamente que las queries de uno nunca devuelven filas del otro. Es barato de escribir y detecta regresiones antes de que lleguen a producción.
Migrar de un modelo a otro
Es común empezar en shared schema y necesitar mover tenants puntuales a un modelo más aislado más adelante. A grandes rasgos, el proceso es este:
- Backfill: copian los datos del tenant desde el shared schema hacia la base o schema nuevo, sin cortar el servicio.
- Dual-write: durante la transición, cada escritura se replica a ambos destinos, para que no se pierda nada mientras dura la migración.
- Validación: comparan que los datos en el destino nuevo coincidan exactamente con el origen.
- Corte de tráfico: cambian el registro del tenant — el
tenant_registryque vimos antes — para que las lecturas y escrituras empiecen a apuntar al nuevo destino. - Cleanup: una vez confirmada la estabilidad, borran los datos del tenant migrado del modelo anterior.
Conviene automatizar esta operación si esperan hacerla más de una o dos veces; muchos SaaS terminan armando una herramienta interna solo para esto.
Checklist para decidir
Antes de comprometerse a un modelo, respondan estas preguntas:
- ¿Cuántos tenants esperan tener en 12 a 24 meses? Cientos versus decenas de miles cambia todo.
- ¿Alguno de sus clientes tiene requisitos regulatorios de residencia o aislamiento de datos?
- ¿Su equipo tiene la capacidad operativa para mantener N bases de datos, o conviene arrancar simple?
- ¿Necesitan reportes o analítica que cruce datos de todos los tenants?
- ¿Están dispuestos a ofrecer tiers de precio distintos según el nivel de aislamiento que necesite cada cliente?
No hay una respuesta única: la decisión correcta depende de en qué etapa está su producto y a qué tipo de cliente le están vendiendo. Lo que sí es un error común es elegir el modelo más complejo “por las dudas” desde el día uno, cuando todavía no tienen ni el primer cliente enterprise que lo justifique.
¿Buscas un especialista para desarrollar, integrar o escalar tu proyecto web? Conoce mis servicios de Desarrollador Freelance en PHP y MySQL.
Para no arrancar de cero
Si vienen del artículo sobre el modelo de base de datos RBAC multi-tenant, ya vieron cómo se ve en código el modelo de shared schema con tenant_id: una tabla tenant, y el resto de las tablas (user, role, permission, etc.) relacionadas a ella.
Ese es justo el punto de partida que usa SaasDragon Pro, la plantilla SaaS multi-tenant con arquitectura MVC en PHP y MySQL que armé para no reinventar este módulo cada vez que arranco un proyecto nuevo.
Si están por arrancar un SaaS y quieren ahorrarse las primeras semanas modelando tenants, roles y permisos desde cero, SaasDragon Pro ya trae este módulo integrado junto con el resto del sistema.
Obtener SaasDragon Pro por $99 USD